O problema não é colocar IA na operação. É decidir onde ela pode julgar — e onde ela precisa parar. CRM, marketing, CS e produto já acumulam texto demais para uma regra fixa e risco demais para entregar cada escolha a um chat. Nesse espaço, Jev é interessante: não como “um agente autônomo”, mas como uma camada rápida de julgamento semântico dentro de um processo que continua tendo regras, dados e responsáveis.
Jev não substitui a operação: ele transforma sinais ambíguos em decisões estruturadas que a operação consegue governar.
O que é Jev — em linguagem de operação
Jev é o primeiro modelo público da TypeSafe AI na categoria que ela chama de System One Models. Em vez de escrever uma resposta em texto, ele recebe um estado e devolve escolhas tipadas, probabilidades e confiança. Na prática, pense em uma função dentro do fluxo: entra o contexto de um lead, ticket ou solicitação; saem campos que o software já sabe consumir, como prioridade, fila, risco e revisao_humana.
A comparação com o “Sistema 1” de Kahneman é útil apenas como metáfora: decisões rápidas e repetíveis. Não significa que o modelo compreenda a empresa por osmose ou que possa receber autonomia total. O valor aparece quando a pergunta é estreita, o resultado possível é conhecido e a consequência está cercada por controles.
Onde cada coisa decide
Uma operação saudável não pede ao mesmo componente que faça tudo. Código e banco guardam aquilo que precisa ser exato; pessoas assumem exceções, impacto e responsabilidade; LLMs são ótimos para linguagem aberta; Jev entra onde existe ambiguidade semântica, mas a saída precisa caber em um contrato.
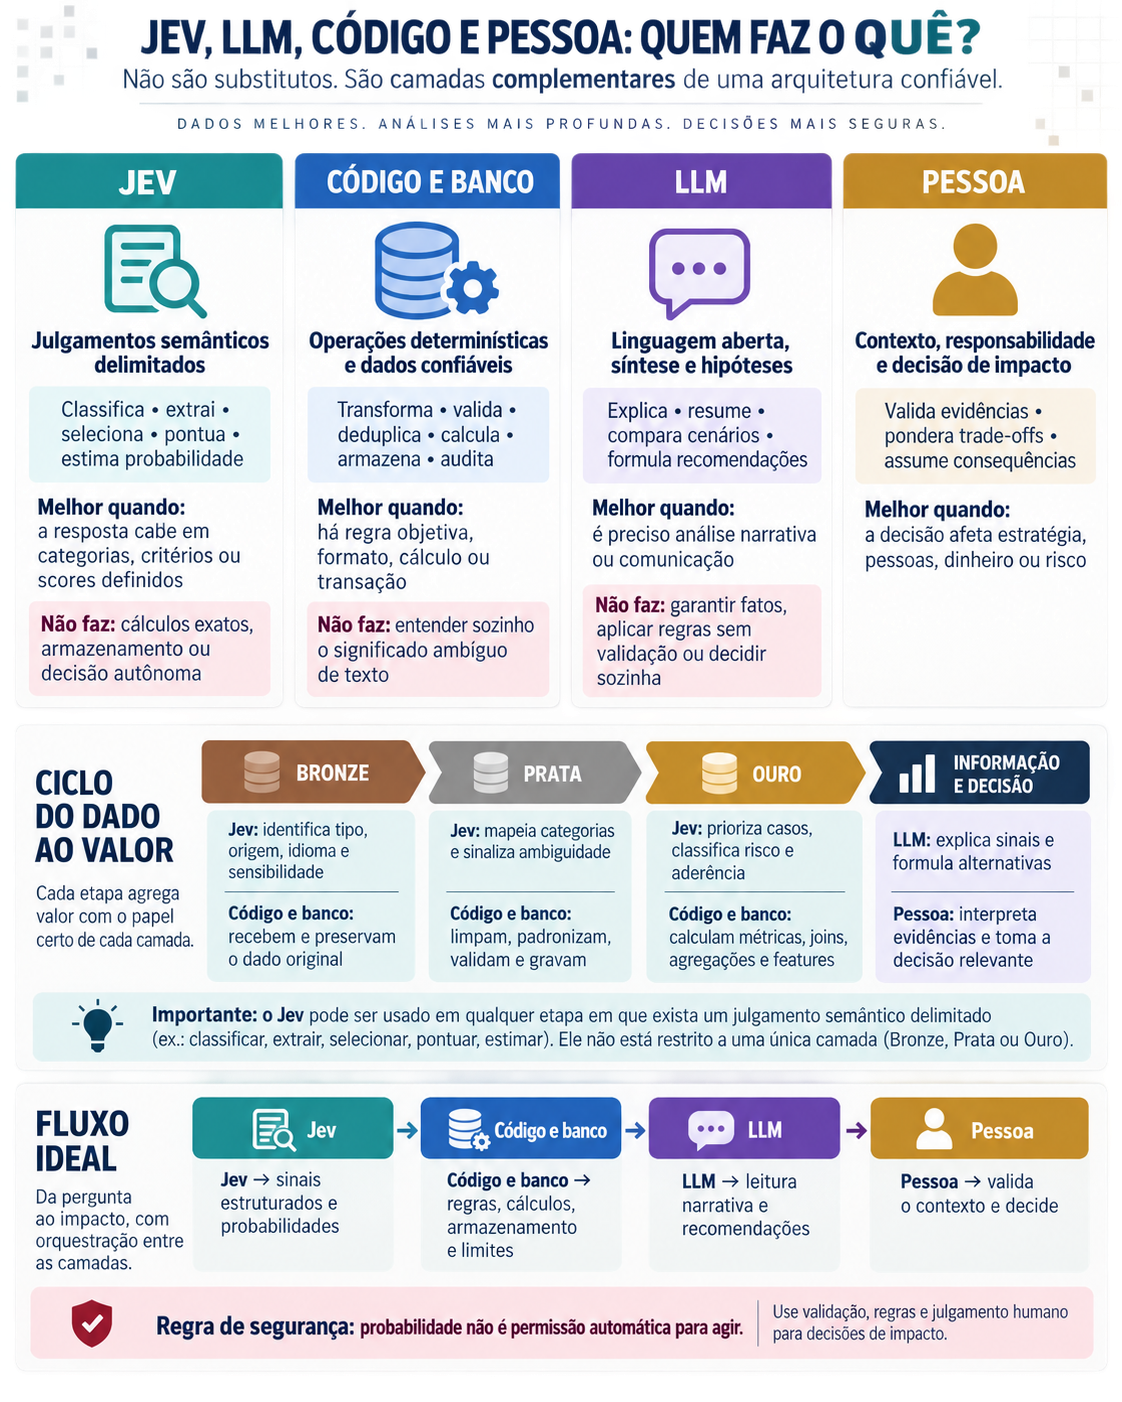
| Componente | Use para | Não entregue a ele |
|---|---|---|
| Banco de dados | Histórico, status, permissões, fonte de verdade | Interpretar intenção em texto livre |
| Código e regras | Elegibilidade, alçadas, integrações, efeitos irreversíveis | Exceções que dependem de linguagem e contexto |
| LLM | Redigir, resumir, investigar, propor alternativas | Ser a única trava antes de uma ação de impacto |
| Jev | Classificar, pontuar, encaminhar e sinalizar incerteza | Inventar uma política, alterar dados críticos ou aprovar sozinho |
| Humano | Definir política, rever bordas e assumir decisões sensíveis | Repetir manualmente toda triagem de baixo risco |
Quatro usos que cabem em CRM, comercial e CS
1. Classificação de intenção
Um formulário pode trazer “quero saber preço”, “minha equipe não usa CRM” ou “preciso organizar leads”. O banco registra a mensagem; Jev pode atribuir intenção, urgência e tema dentro de um conjunto fechado. A automação então sugere a etapa, mas só cria tarefa ou muda um campo se as regras de alçada permitirem.
2. Routing com explicação operacional
Em suporte e CS, a decisão não é “responder ou não”. É escolher a fila: bug, onboarding, cobrança, risco de churn, pedido de funcionalidade ou caso sensível. Encaminhar já com confiança e motivos observáveis diminui a triagem; confiança baixa manda o caso para uma fila de revisão, não para uma resposta automática confiante.
3. Priorização sem fingir que o score é verdade
O modelo pode estimar prioridade a partir de contexto recente: prazo citado, impacto declarado, estágio da conta, tentativas anteriores. Esse score é um sinal para ordenar trabalho, não uma sentença sobre o cliente. Antes de disparar uma campanha, pausar conta ou prometer SLA, cruzar o score com dados determinísticos e uma política explícita.
4. Validação de saída de LLM
Um LLM pode redigir uma resposta comercial, resumo de call ou proposta de abordagem. Jev pode avaliar, em formato estruturado, se a saída contém promessa não autorizada, dado não verificável, tom inadequado ou próxima ação sem dono. Ele não “prova a verdade” do texto; cria uma barreira de revisão que ajuda a decidir se publica, reescreve ou escala.
A arquitetura prática: contexto, decisão, política e revisão
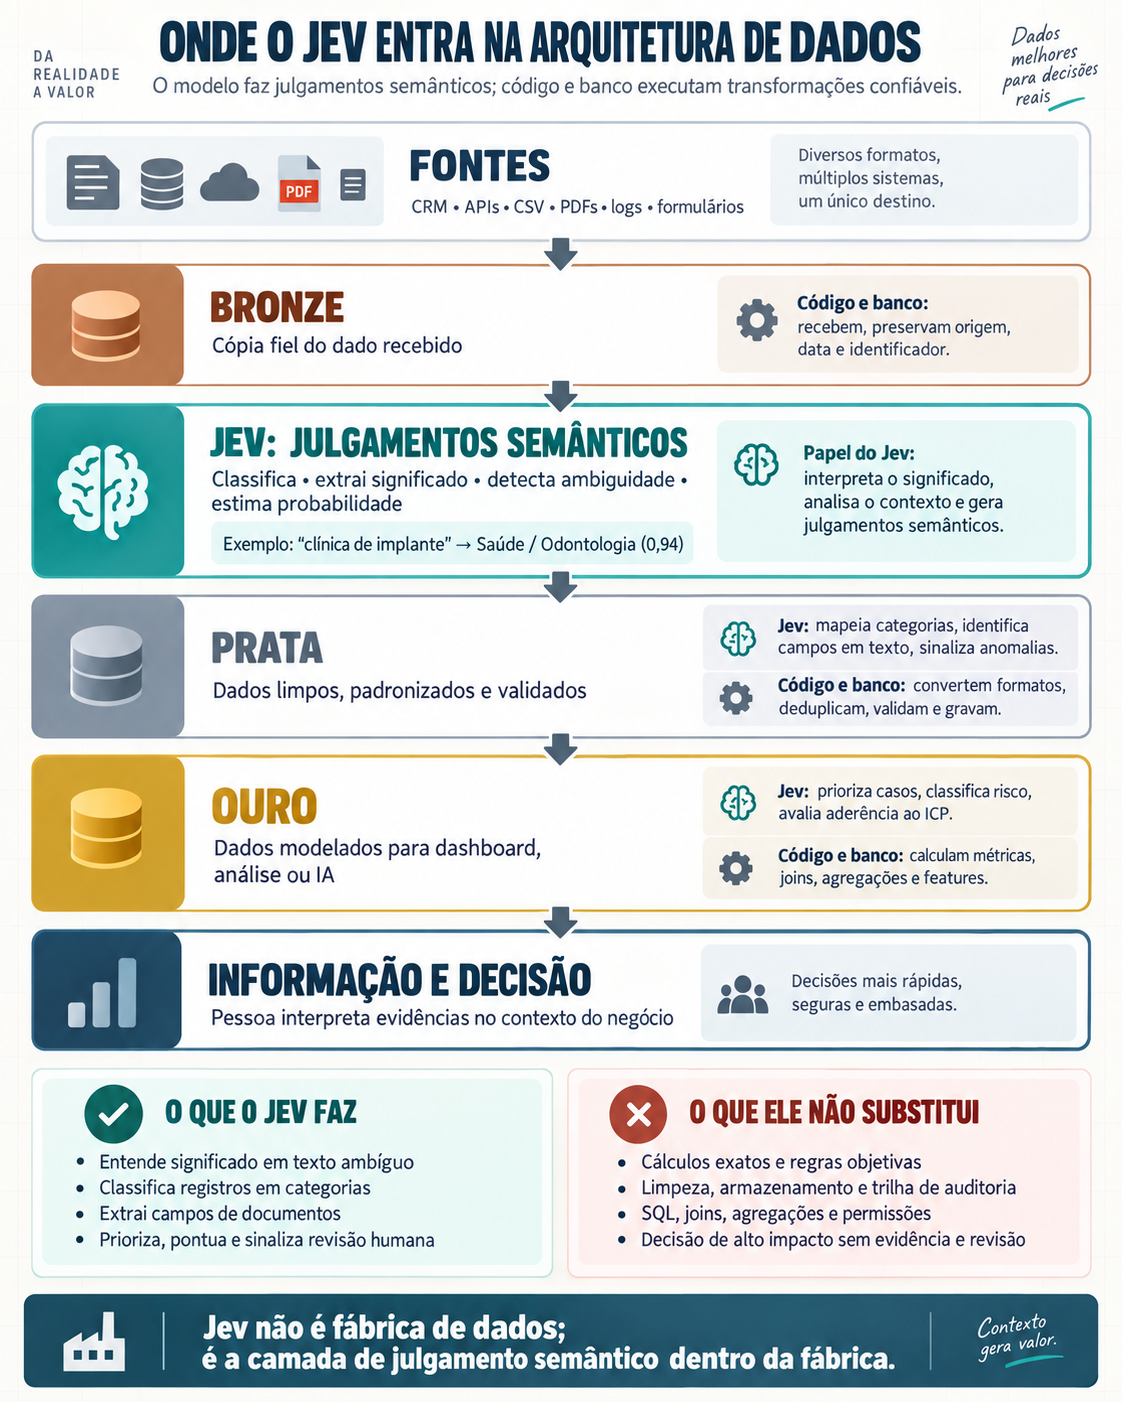
- Defina a decisão: “este ticket é cobrança, bug, onboarding ou risco?”, e não “entenda tudo sobre este cliente”.
- Construa um estado mínimo: texto relevante, campos do CRM e fatos datados; nada de despejar histórico inteiro sem critério.
- Feche as saídas: classes, faixas de score e uma flag de revisão. Se a resposta aceitável não cabe em um schema, a decisão ainda está mal definida.
- Escreva a política fora do modelo: confiança abaixo de um limiar vira revisão; categorias sensíveis nunca acionam automação; efeitos externos exigem a regra correspondente.
- Meça e corrija: compare decisão, revisão humana, tempo de resposta e erros por categoria. O limiar não é uma constante mágica.
O que os benchmarks da TypeSafe dizem — e o que não dizem
A TypeSafe afirma que Jev produz saídas tipadas em paralelo e divulga benchmarks de fluxos próprios com ganhos de velocidade e custo. São alegações e avaliações do fornecedor, úteis como hipótese para teste, não como prova de desempenho no seu CRM. A própria publicação descreve vieses possíveis: os fluxos foram produzidos por pessoas da equipe e uma demonstração usa entrada curta, o que favorece o formato.
O experimento de Pokémon, reportado pela Tom’s Hardware, é um bom antídoto à leitura de “autonomia”. Jev escolhia entre opções apresentadas; Claude Opus 5, o desenvolvedor e a comunidade ajustaram a representação e o harness quando surgiram falhas. O resultado ilustra composição de componentes, não um modelo que resolveu sozinho um ambiente aberto.
Jev e Laya: parecidos na categoria, diferentes no produto
O projeto open source Laya também se apresenta como motor não autorregressivo de decisões tipadas, com escolhas, scores e respostas sim/não. Isso o torna uma alternativa relevante para testar especialmente quando deploy, custo e abertura do stack importam.
Mas “ambos fazem System 1” não é equivalência. API, checkpoints, idiomas, latência, calibração, licenças, segurança, observabilidade e desempenho no seu domínio precisam ser comparados no mesmo conjunto de casos. O README de Laya publica números e benchmarks próprios; eles também são claims do projeto até que você reproduza um teste representativo.
O primeiro piloto que vale a pena
Escolha uma decisão frequente, reversível e hoje manual — por exemplo, classificar tickets de onboarding em quatro filas. Monte um conjunto histórico revisado por pessoas, separe uma amostra de teste e defina o custo de cada erro. Rode Jev, Laya e a regra/LLM atual sob o mesmo schema. Depois escolha por precisão por classe, calibração, latência, custo e capacidade de mandar a dúvida para a pessoa certa.
O ganho não é “tirar humanos do processo”. É concentrá-los onde seu julgamento altera o resultado, enquanto o resto da operação deixa de confundir ambiguidade com improviso.
FAQ
Jev substitui um LLM?
Não. Um LLM continua mais apropriado para geração e investigação abertas. Jev é proposto para decisões estruturadas dentro de software.
Jev pode decidir sozinho no CRM?
Só decisões de baixo risco, reversíveis e cobertas por política explícita deveriam automatizar. Decisões sensíveis exigem alçada e revisão humana.
Como usar Jev em marketing?
Classifique intenção, tema, estágio e risco de uma mensagem; use o resultado para organizar a próxima ação. Não use um score sem validação como licença para abordar ou excluir pessoas.
Laya é igual ao Jev?
Não. Eles compartilham ideias de decisões não autorregressivas e tipadas, mas devem ser comparados por implementação e avaliação no caso de uso real.